アリババが GitHub で公開している page-agent を知った。
ひとことで言うと、「Web ページに AI エージェントを住まわせる」JavaScript ライブラリだ。README のキャッチコピーは「The GUI Agent Living in Your Webpage」。お試しなら <script> タグを 1 行貼るだけで、そのページにチャット欄が現れて、AI がページを読んだり操作したりしてくれる。
デモを見て、少し触ってみた。正直、「サイト内検索って、もういらないんじゃないか」と思ってしまった。
page-agent ってなに?
page-agent は、アリババの GitHub organization(alibaba/page-agent)で MIT ライセンスで公開されているオープンソースだ。v1.0.0 が 2026 年 1 月に出て、3 月ごろには Hacker News や GitHub Trending で話題になった。いまも活発に更新されていて、この記事を書いている時点の最新は v1.12.4(2026 年 9 月 6 日)、スターは 2.9 万を超えている。
特徴は、全部ページの中で完結すること。
- ブラウザ拡張も Python もヘッドレスブラウザもいらない。ページに読み込んだ JavaScript だけで動く
- スクリーンショットを撮って画像認識する方式ではなく、DOM をテキストとして LLM に渡す。なのでマルチモーダルモデルもいらない
- LLM は自分で選べる(OpenAI 互換 API で、tool call に対応したモデル)。Qwen、GPT、Claude、Gemini、DeepSeek などが並んでいて、Ollama などのローカルモデルにもつなげる
ちなみに、DOM の処理部分やプロンプトは、ブラウザ自動化で有名な browser-use をベースにしていると明記されている。browser-use が「外からブラウザを操る自動化ツール」なのに対して、page-agent は「サイトの作り手がページに組み込む部品」という立ち位置だ。
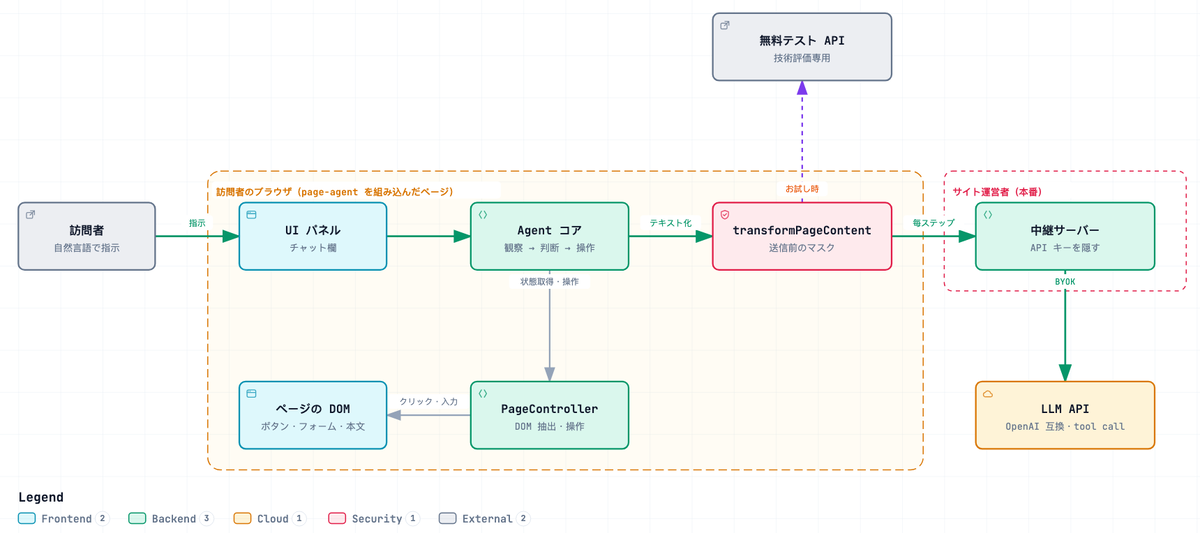
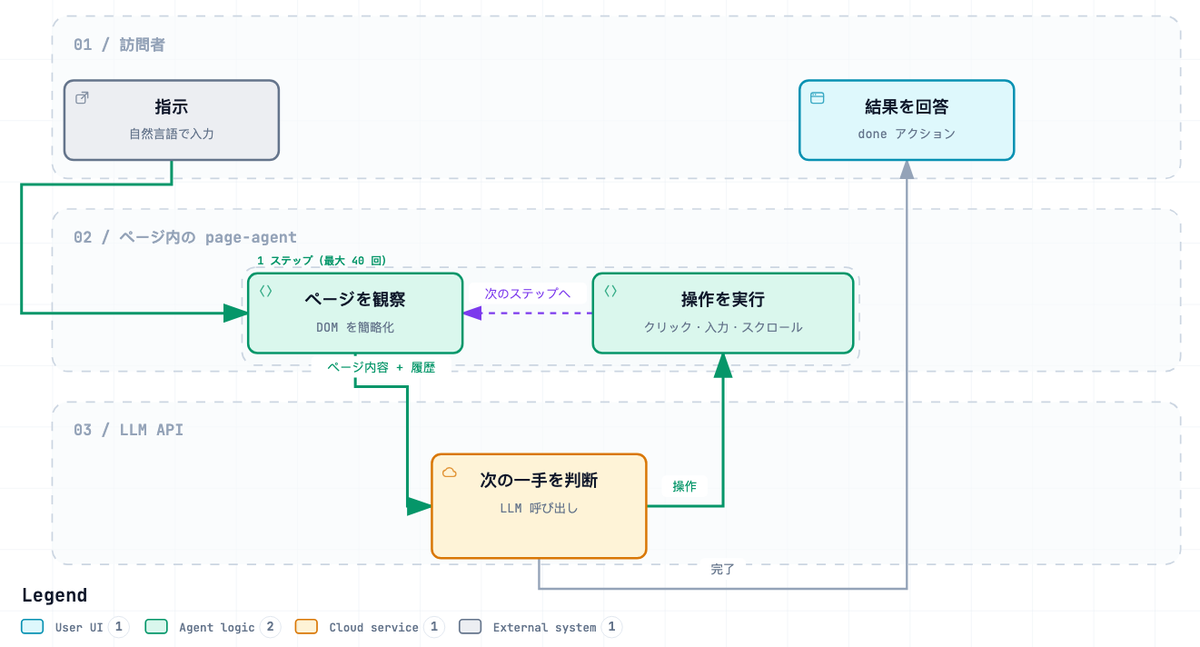
全体の構成を図にするとこんな感じ。
1 行で試せる
試すだけなら本当にこれだけ。
<script
    src="https://cdn.jsdelivr.net/npm/page-agent@1.12.4/dist/iife/page-agent.demo.js"
    crossorigin="anonymous"
></script>
これを貼ったページを開くと、エージェントのパネルが出てくる。あとは話しかければいい。
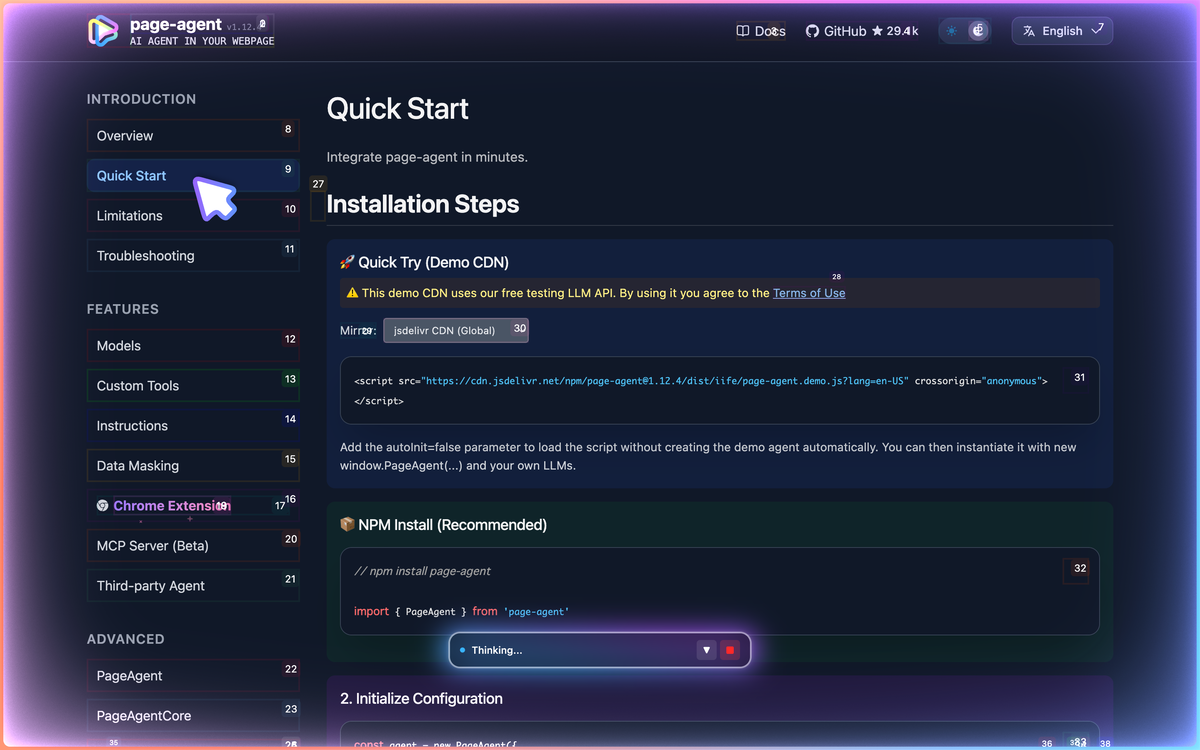
公式サイトのデモでも試せる。最初から入っている指示(「ナビゲーションの Docs から Quick Start を探して、Markdown で要約して」)で Run を押してみた。
エージェントは自分で Docs を開き、Quick Start のページへ移動する。画面上のボタンやリンクに番号が振られているのは、エージェントが DOM から拾った「操作できる要素」だ。LLM はこの番号を指定して「9 番をクリック」のように操作を決めている。
しばらくすると「Task completed」になり、パネルに Quick Start の内容をまとめた Markdown が返ってきた。
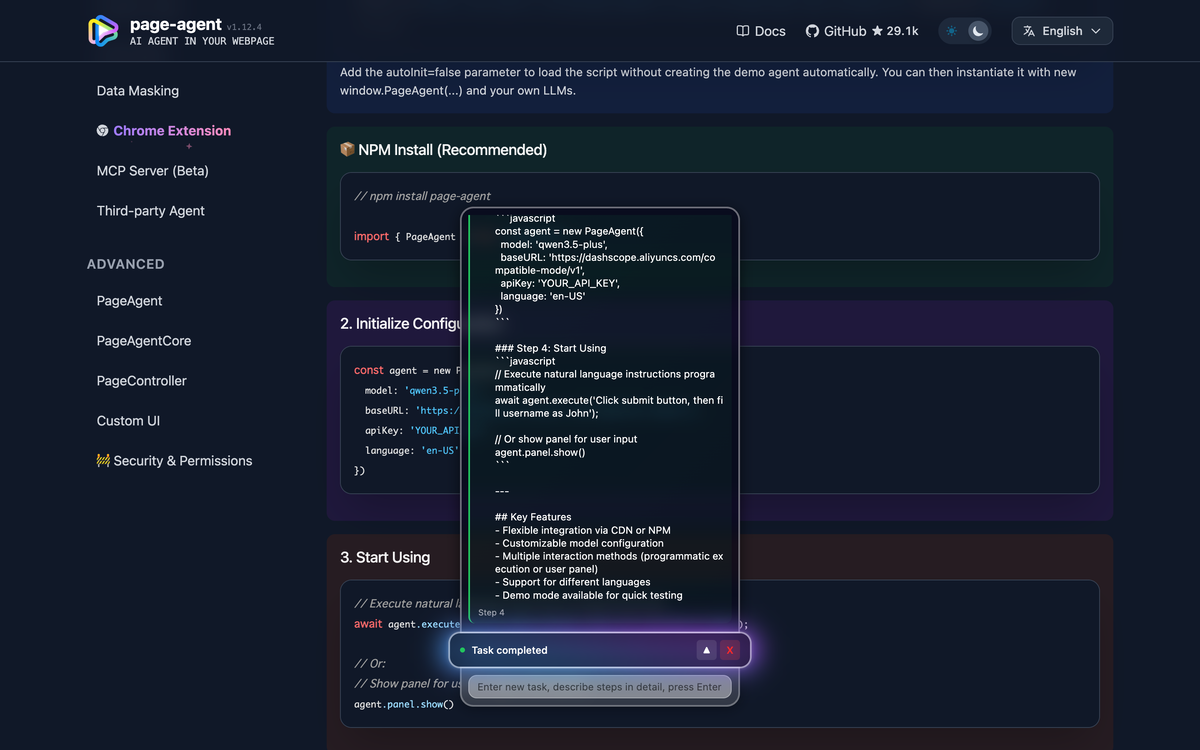
(画像はいずれも page-agent 公式デモ の画面)
触ってみて変わったこと
Web サイトって、けっこう迷子になる。
目的の情報がどのメニューの下にあるのかわからない。サイト内検索を使ってみても、キーワードが合わなければ何も出てこないし、出てきても結果の一覧からまた自分で探すことになる。
page-agent だと、この体験がチャットに置きかわる。
- 「こんなことが知りたい」 → エージェントがページを読んで、まとめて答えてくれる
- 「このページに行きたい」 → エージェントがサッとボタンやリンクを押して連れて行ってくれる
仕組みとしては、エージェントが「いまのページの状態を見る → 次にやることを決める → クリックや入力をする → 結果を確認する」というループを回している。操作が終わったら、わかったことを文章で返してくれる。
ほかにも、公式ではこんな使い方が挙がっている。
- フォーム入力の代行:20 回クリックする業務フローを 1 文で。ERP や CRM、管理画面向け
- サポートボットの強化:「設定ボタンを押して、次に…」と説明するだけのボットから、実際に操作してくれるボットへ
- アクセシビリティ:自然言語や音声で Web アプリを操作できるようにする
ちょっと触っただけでも、「サイトの中を自分で探し回る」という前提がひっくり返る感覚があった。
ただし、万能ではない
盛り上がったところで、ドキュメントに書かれている制約も確認しておく。
基本は「いまのページ」が守備範囲。 ライブラリ単体(PageAgent.js)が操作できるのは現在のページで、SPA(シングルページアプリ)向けに設計されている。複数タブをまたぐような操作は、ユーザーが別途 Chrome 拡張(Page Agent Ext)を入れる必要がある。
サイト全体の索引を持っているわけではない。 ページの DOM を読んで動くので、サイト内検索エンジンのように全ページの中身を事前にインデックスしているわけではない。「サイト内検索が完全にいらなくなる」かというと、サイトの作りによっては検索と組み合わせることになりそうだ。
見た目だけの情報は読めない。 画像や Canvas、WebGL、SVG の中身は認識できない。ホバーやドラッグ&ドロップ、右クリック、キーボードショートカットにも非対応。逆に言うと、セマンティックな HTML でアクセシビリティがちゃんとしているサイトほど精度が上がる。
安全面の仕掛けは自分で入れる。 操作していい要素・ダメな要素の許可リスト/ブロックリスト、送信前にページ内容をマスクするフック(transformPageContent)、危険な操作を禁止したりユーザー確認を挟んだりする指示などが用意されている。
便利さの代償は LLM の費用
そして一番気になるのがここ。
page-agent は、ステップごとに LLM を呼び出す。1 つの指示でも、ページを見て、操作して、また見て…と何往復もする。1 タスクあたりの最大ステップ数(maxSteps)はデフォルトで 40。しかも毎回、簡略化したページ内容を LLM に送るので、トークンはそれなりに積み上がる。
社内の管理画面くらいならまだしも、誰でもアクセスできる公開サイトに入れたら、訪問者のひと言ひと言に LLM の費用がかかる。アクセスが多いサイトだと、請求額に驚くことになりそうだ。
加えて、公開サイトならではの注意点もある。
- 1 行で試せるデモ版は本番では使えない。 デモ CDN は、メンテナーが用意した無料のテスト用 LLM API につながっていて、「技術評価と研究開発専用、本番環境での利用は禁止」と規約に書かれている。データは中国本土のサーバーで処理されるので、個人情報や機密データは入れないこと、とも明記されている
- 本番では自分の LLM を設定する。 npm で入れるか、
?autoInit=false を付けて読み込み、自分の API エンドポイントを指定する。ブラウザで動くライブラリなので、API キーをそのままフロントに書くと丸見えになる。公開サイトなら、キーを隠す中継サーバーを挟むことになるだろう
費用を抑える方向としては、公式も「tool call に強い軽量モデル」を推奨していて、gpt-5.4-mini や claude-haiku-4-5、gemini-3.8-flash、qwen3.5-flash などが推奨として挙がっている。社内システムならローカルモデルという手もある。
それでも、たぶん戻れない
とはいえ、一度この体験をすると戻れない気がする。
「サイトの中を自分で探す」から「サイトに聞く」へ。それが、ページにスクリプトを入れるだけで手に入る。サイトの作り手にとっても、バックエンドを作り直さずに AI の入口を用意できるのは大きい。
Web サイトとの付き合い方は、きっとこういう方向に変わっていくんだろうな。
あとは費用の問題さえ解決できれば…。
参考